Stage chez HLP Services
Refonte de l'export de données de MAPPSY, une suite de pilotage industriel : plus rapide, sans bloquer le navigateur et suivie par l'utilisateur.
Fonctionnalités principales
- Nouveau flux d'export asynchrone basé sur des jobs, avec progression et historique
- Envoi des données par lots (NDJSON) et génération du fichier Excel en streaming
- Profiler de la chaîne d'export pour mesurer chaque étape
- Requête optimisée dans la VRS API (MongoDB) avec repli sur l'ancien chemin
- Migration d'un projet Symfony ancien vers PHP 8.3
- Import BOAMP pour pré-remplir les marchés publics
Défis et solutions
- 01
Problème. Les gros exports dépassaient la limite post_max_size, saturaient la mémoire PHP et bloquaient le navigateur.
Solution. Découpage en jobs et en lots, stockage temporaire par feuille et génération progressive avec OpenSpout.
- 02
Problème. Savoir d'où venait vraiment la lenteur : données, transfert ou moteur de génération.
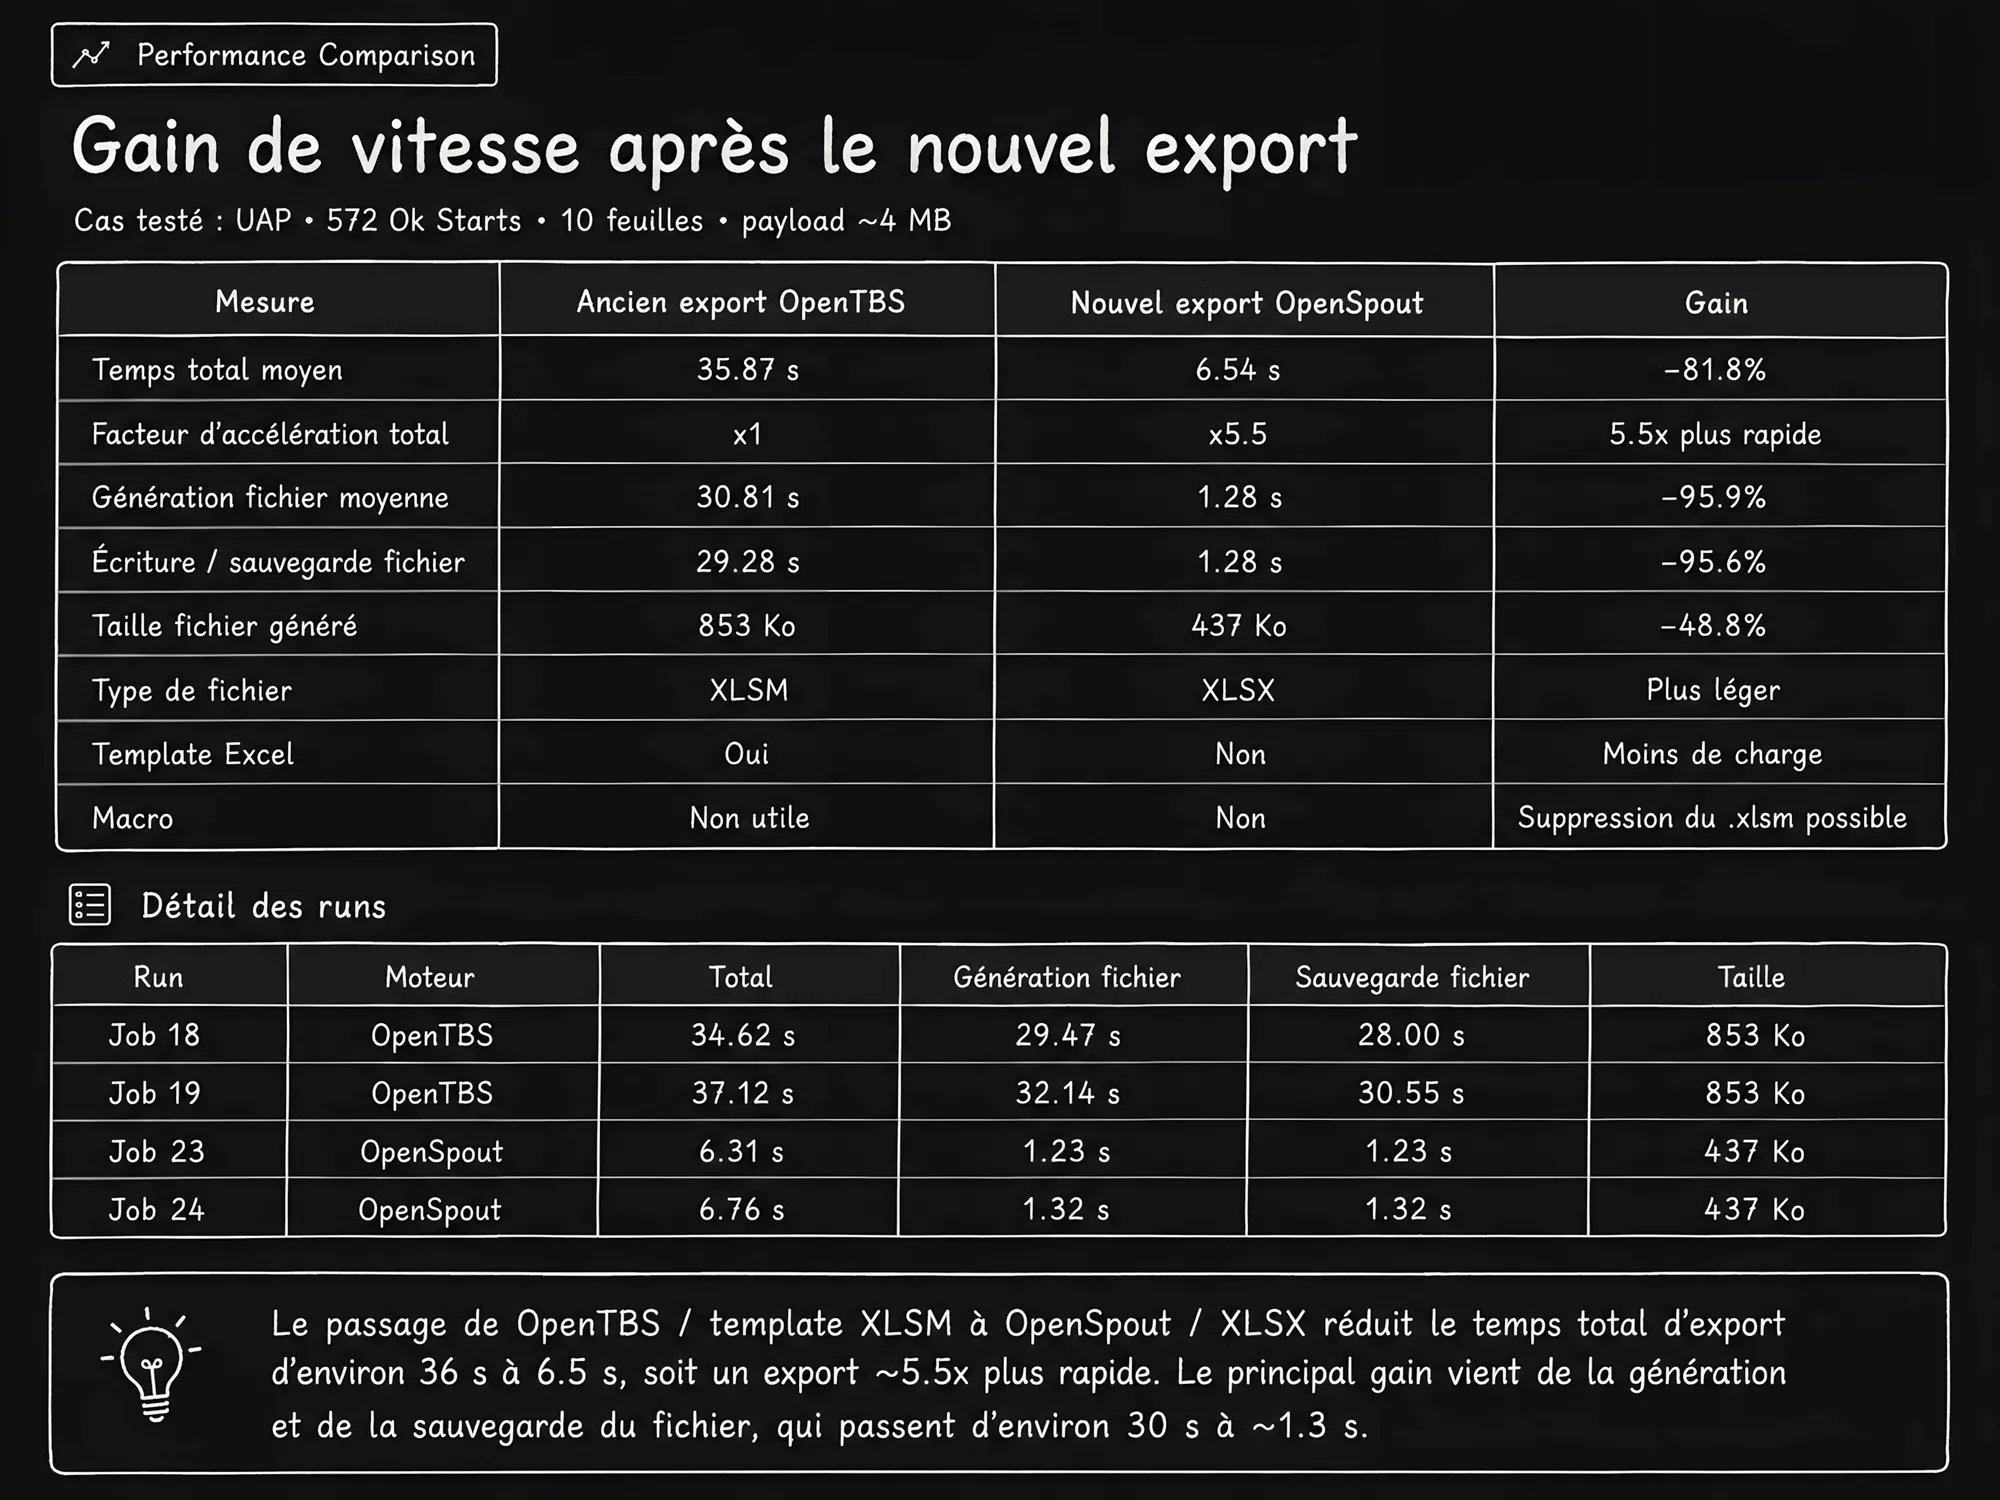
Solution. Mise en place d'un profiler et d'un benchmark chiffré avant toute modification.
L'entreprise et mon environnement
HLP Services développe MAPPSY, une suite logicielle qui aide les usines à piloter leur performance : management visuel, supervision de production, suivi terrain, contrôles, audits et amélioration continue. Pendant ces deux mois, j'ai travaillé sur plusieurs parties de cet ensemble : le frontend Angular, l'API PHP / Slim, l'API VRS en NestJS, les bases MongoDB et MySQL, ainsi qu'un projet plus ancien en Symfony lié aux marchés publics.
Le sujet qui a structuré mon stage est la refonte de l'export Cockpit. Cockpit est le tableau de bord de MAPPSY ; ses exports Excel pouvaient contenir des dizaines de milliers de lignes. L'ancien système envoyait toutes les données en une fois et remplissait un modèle Excel complet avec la bibliothèque OpenTBS. Résultat : des exports lents, un navigateur bloqué pendant la génération, un risque de dépasser la limite post_max_size du serveur et aucune visibilité pour l'utilisateur.
Mesurer avant d'optimiser
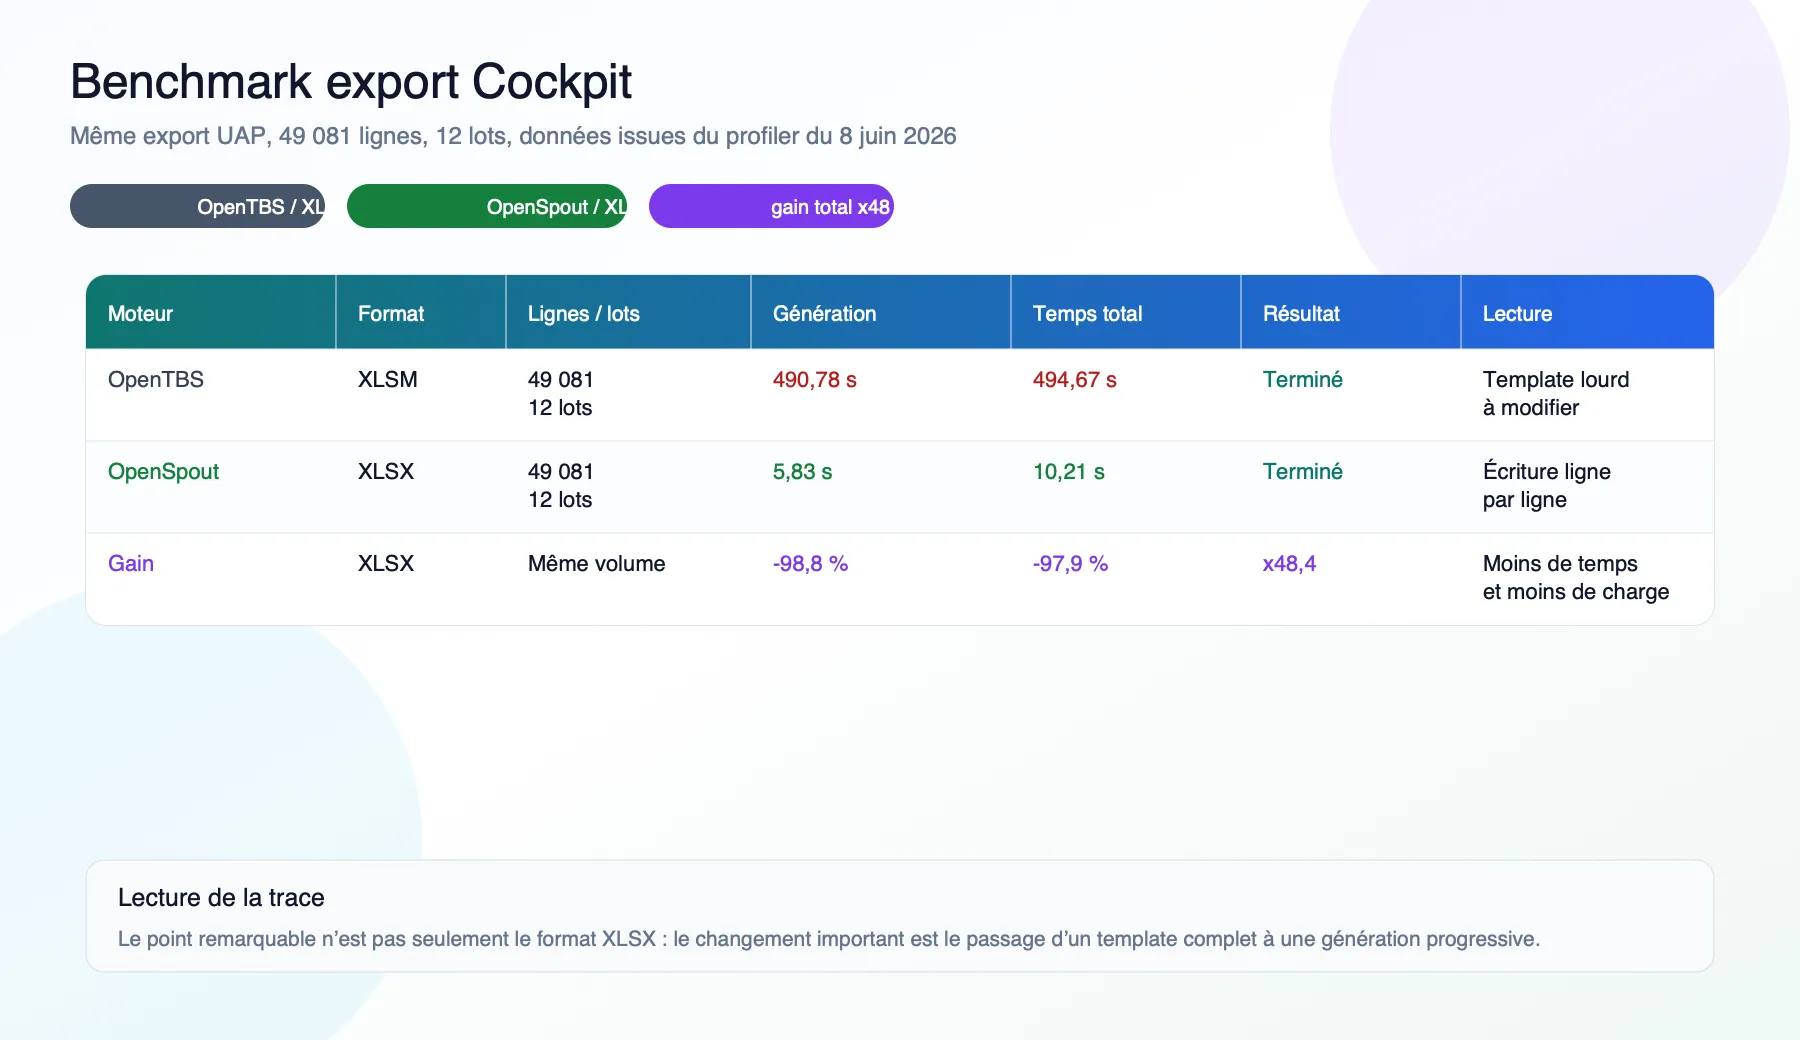
La figure 1 compare l'ancien moteur et le nouveau sur exactement le même export Cockpit : 49 081 lignes envoyées en 12 lots. Avant de changer quoi que ce soit, il fallait savoir si la lenteur venait du volume de données, du transfert ou du moteur de génération. Ce tableau montre que le gain principal vient du passage d'un modèle Excel complet à une génération progressive avec OpenSpout.
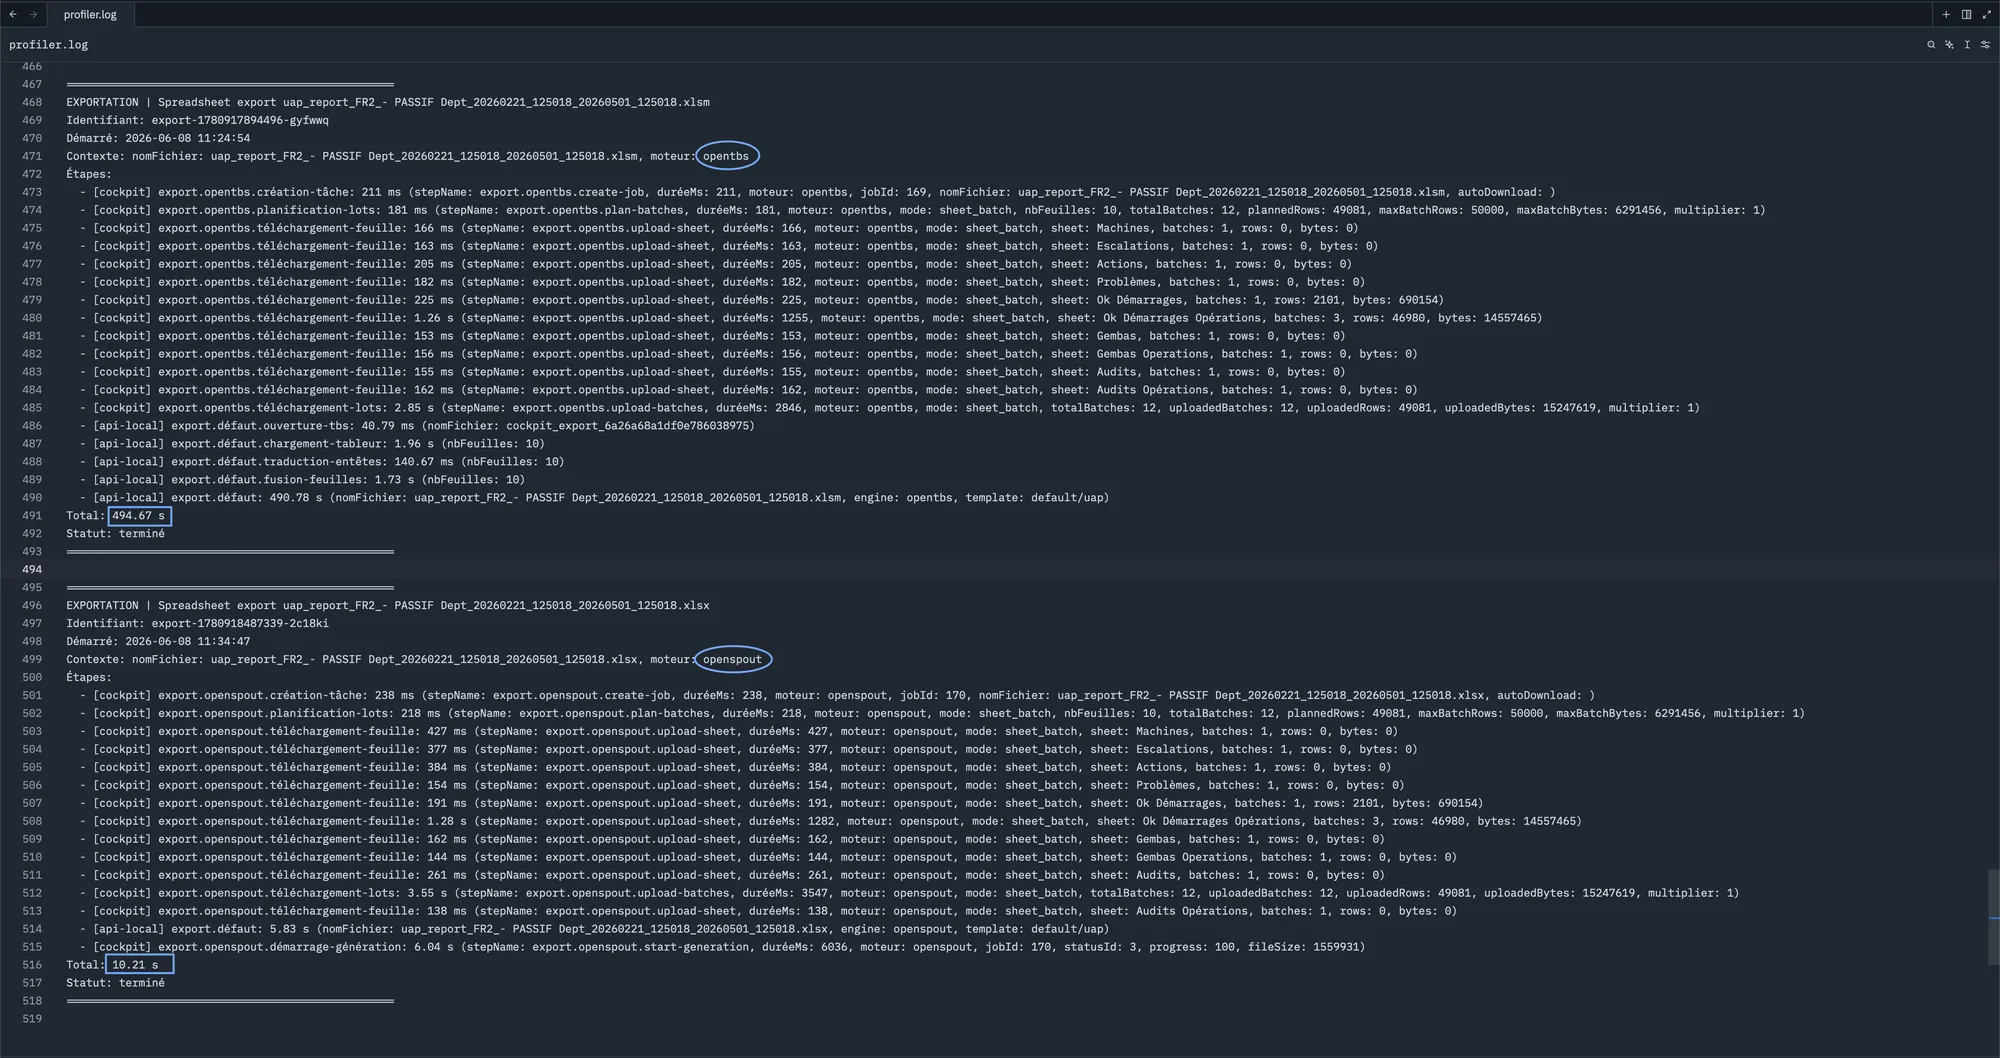
Pour obtenir ces chiffres, j'ai ajouté un profiler à la chaîne d'export (figure 2). Il enregistre la durée de chaque étape : recherche des données, envoi, génération du fichier et sauvegarde. Les zones entourées en bleu montrent les deux informations utiles pour comparer deux exécutions : le moteur utilisé et le temps total. C'est ce stage qui m'a appris à toujours mesurer avant d'optimiser ; je l'ai réutilisé ensuite sur Prior et Deep Salvage.
Une nouvelle architecture d'export
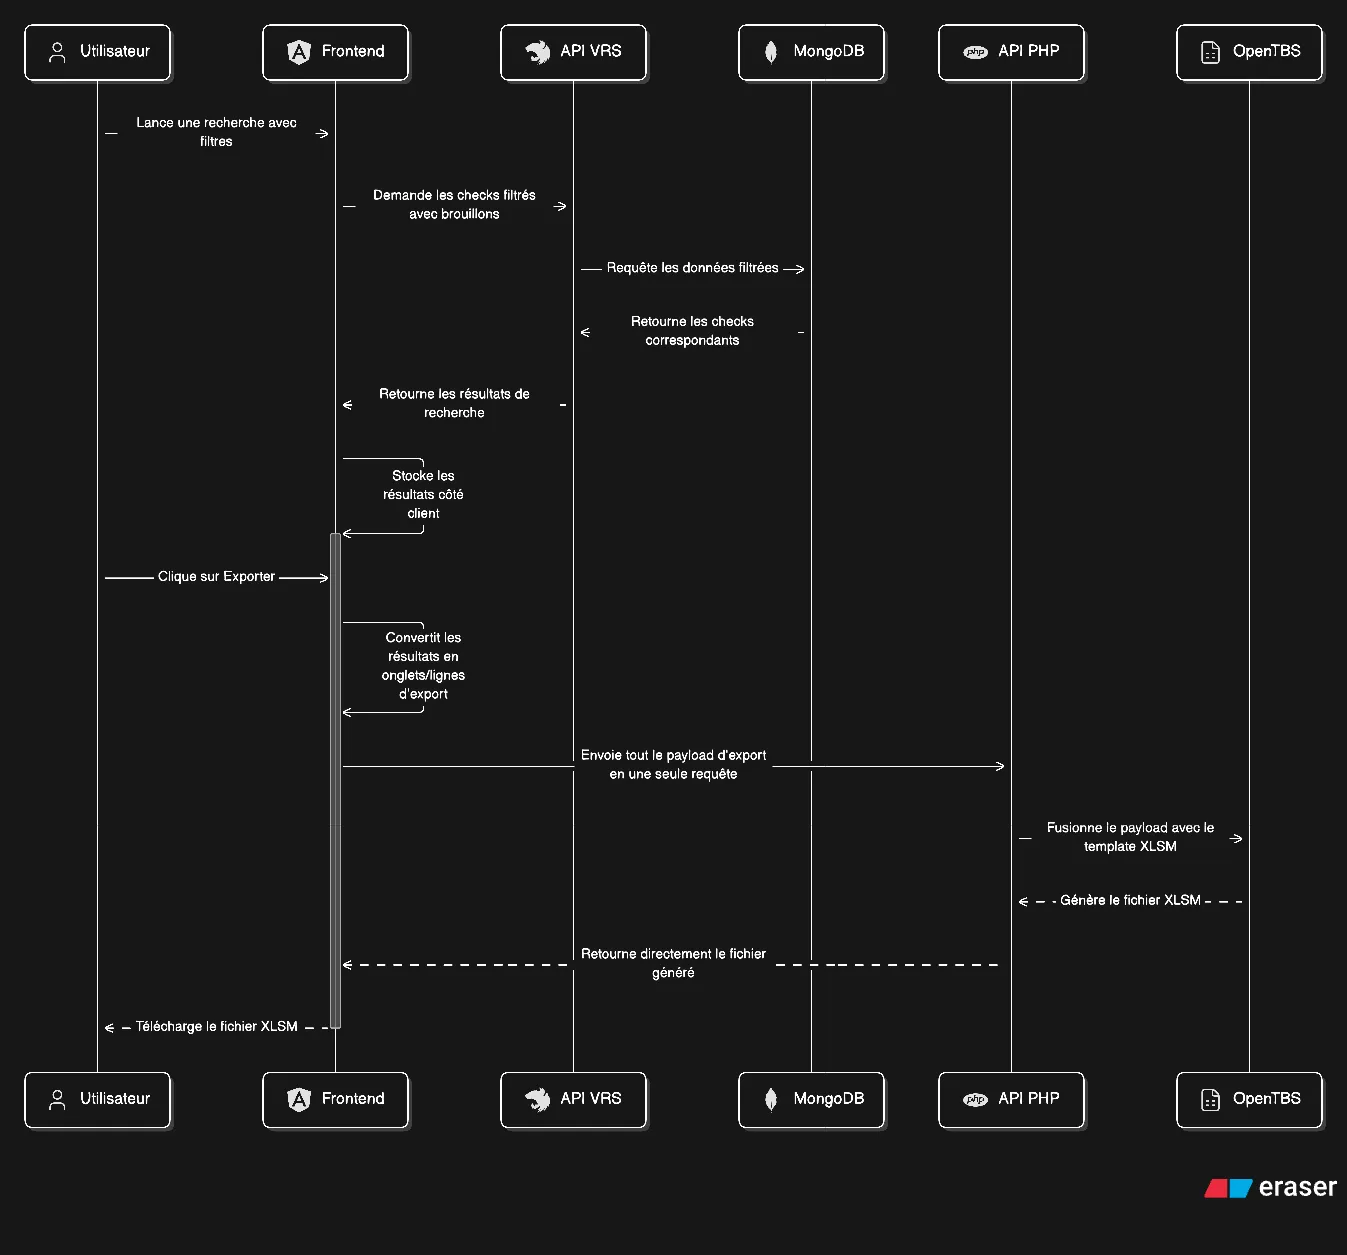
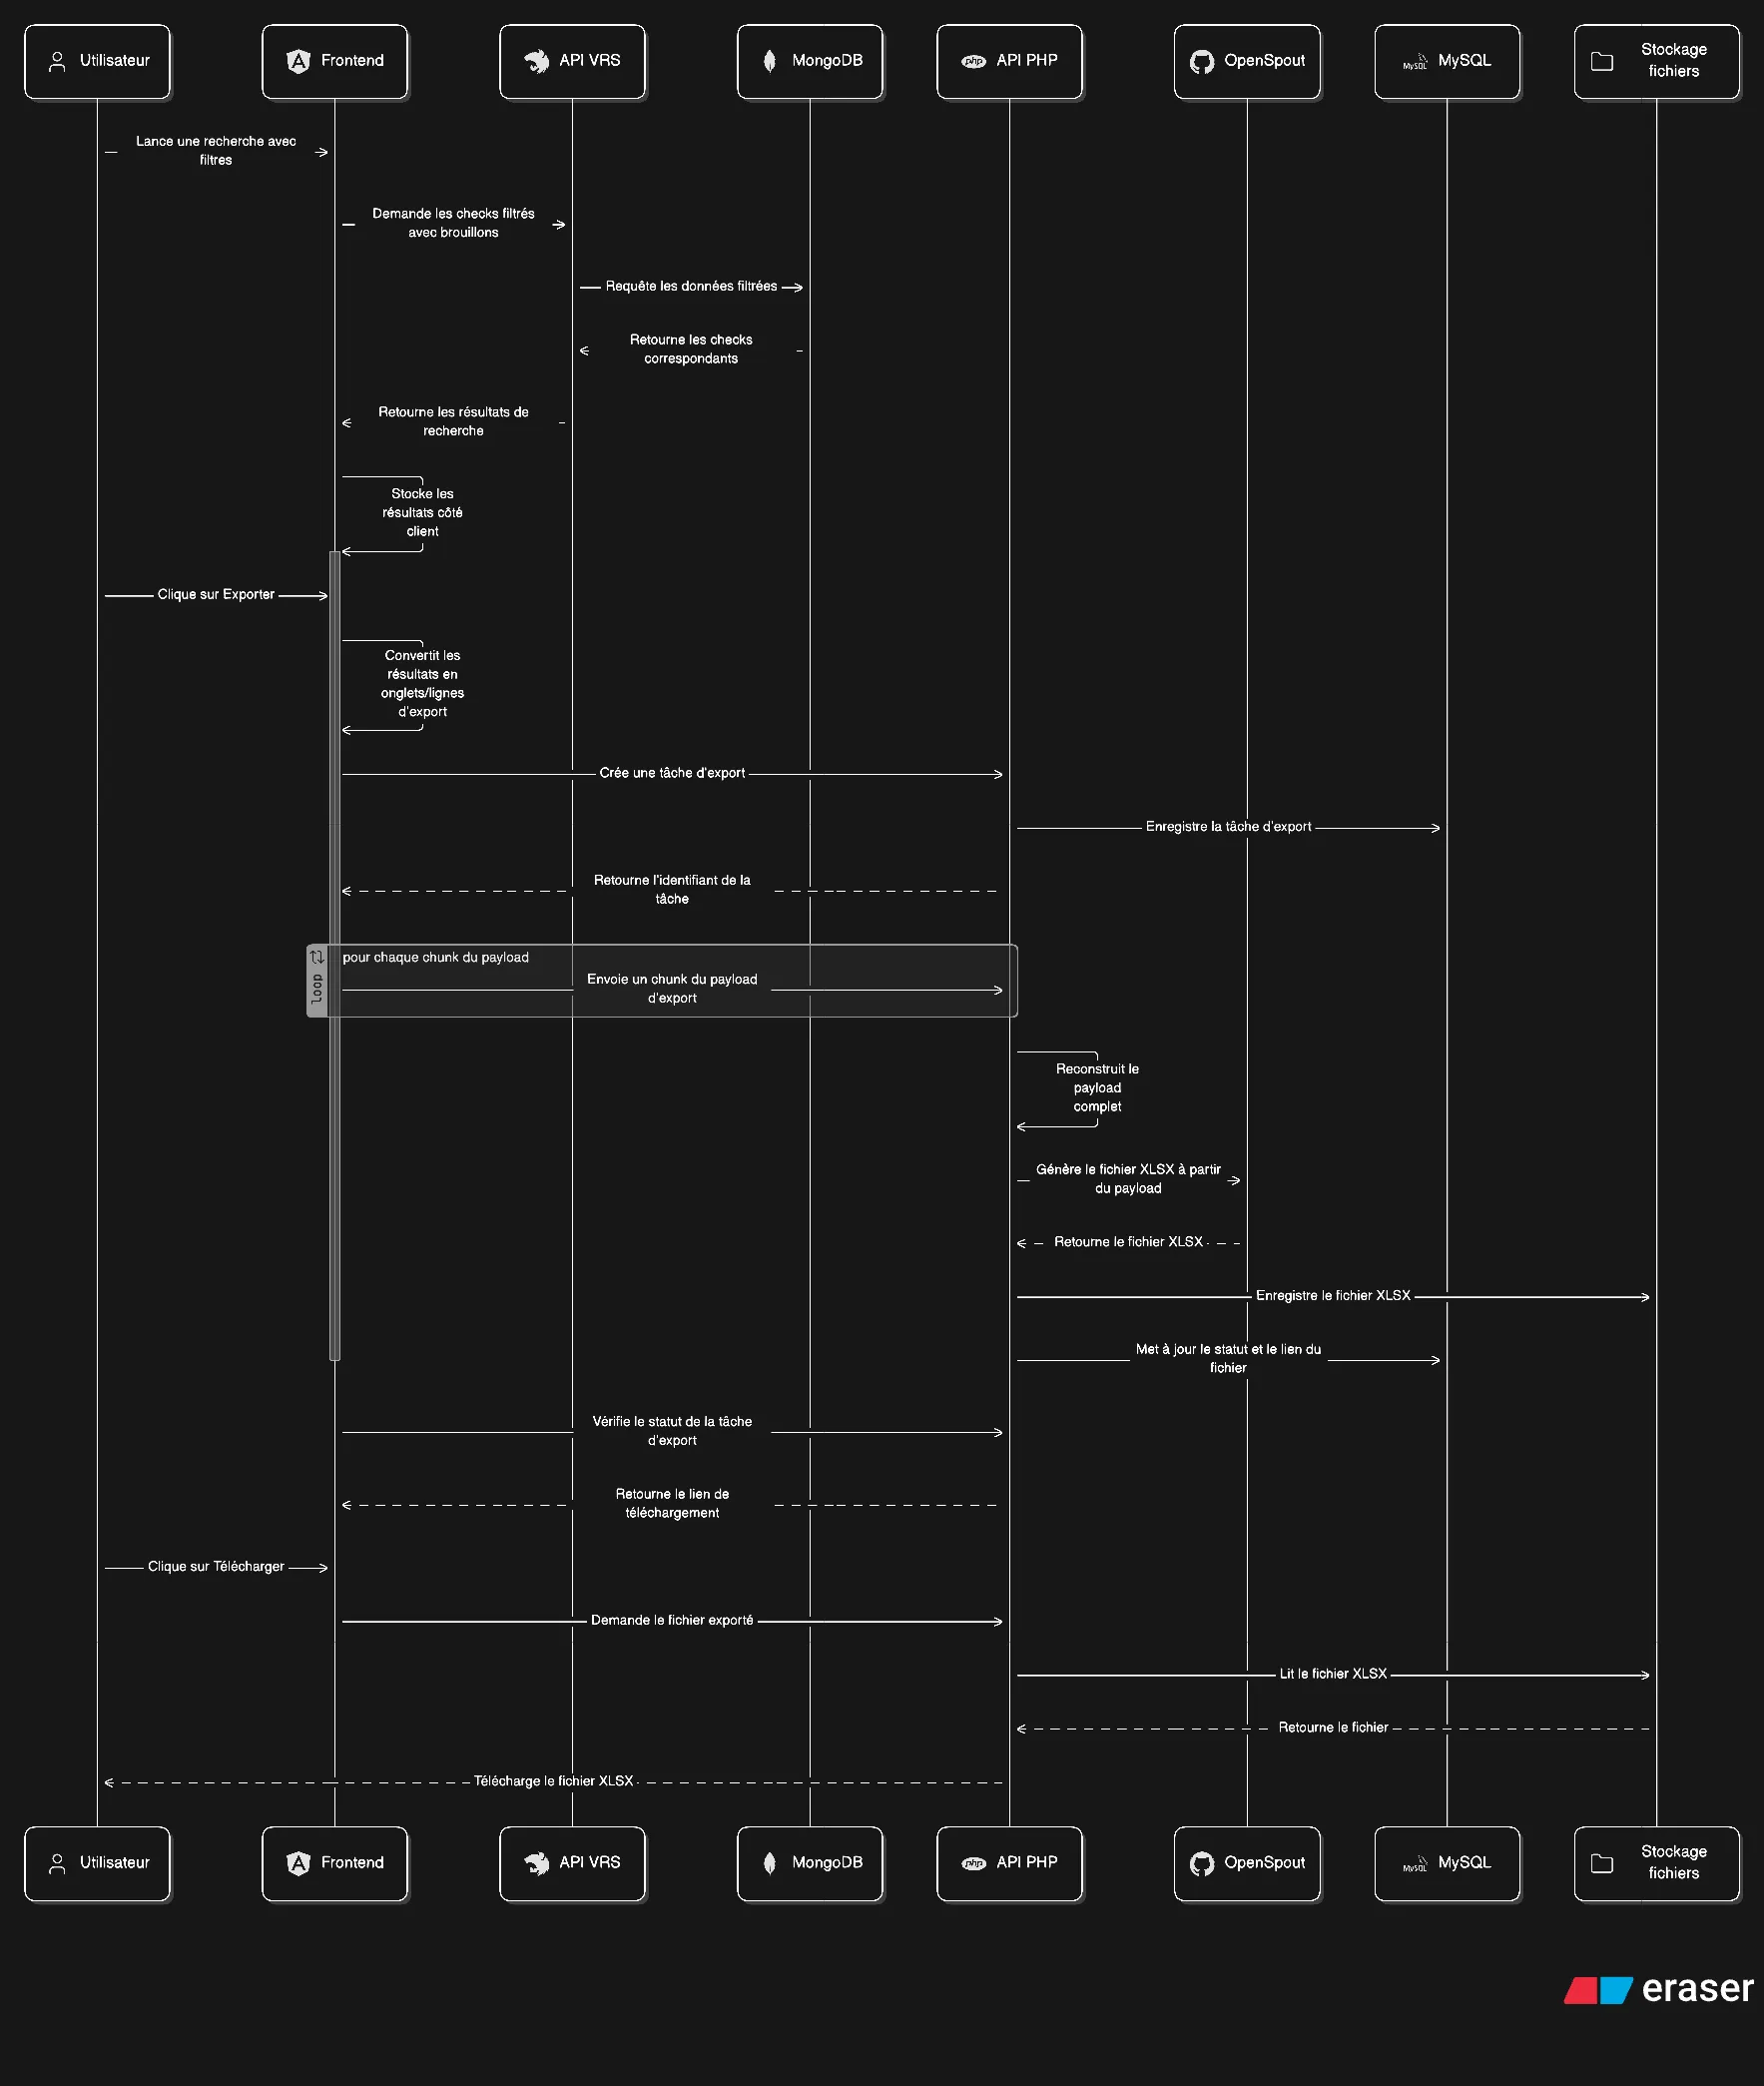
Les figures 4 et 5 comparent l'ancien et le nouveau fonctionnement. Dans le nouveau, l'export devient un job : le frontend le crée, envoie les données, puis interroge régulièrement son état. Le backend conserve l'identifiant, le statut, la progression, le lien du fichier et l'historique de l'utilisateur. Une génération qui échoue n'est plus perdue avec la requête : elle est visible et peut être relancée.
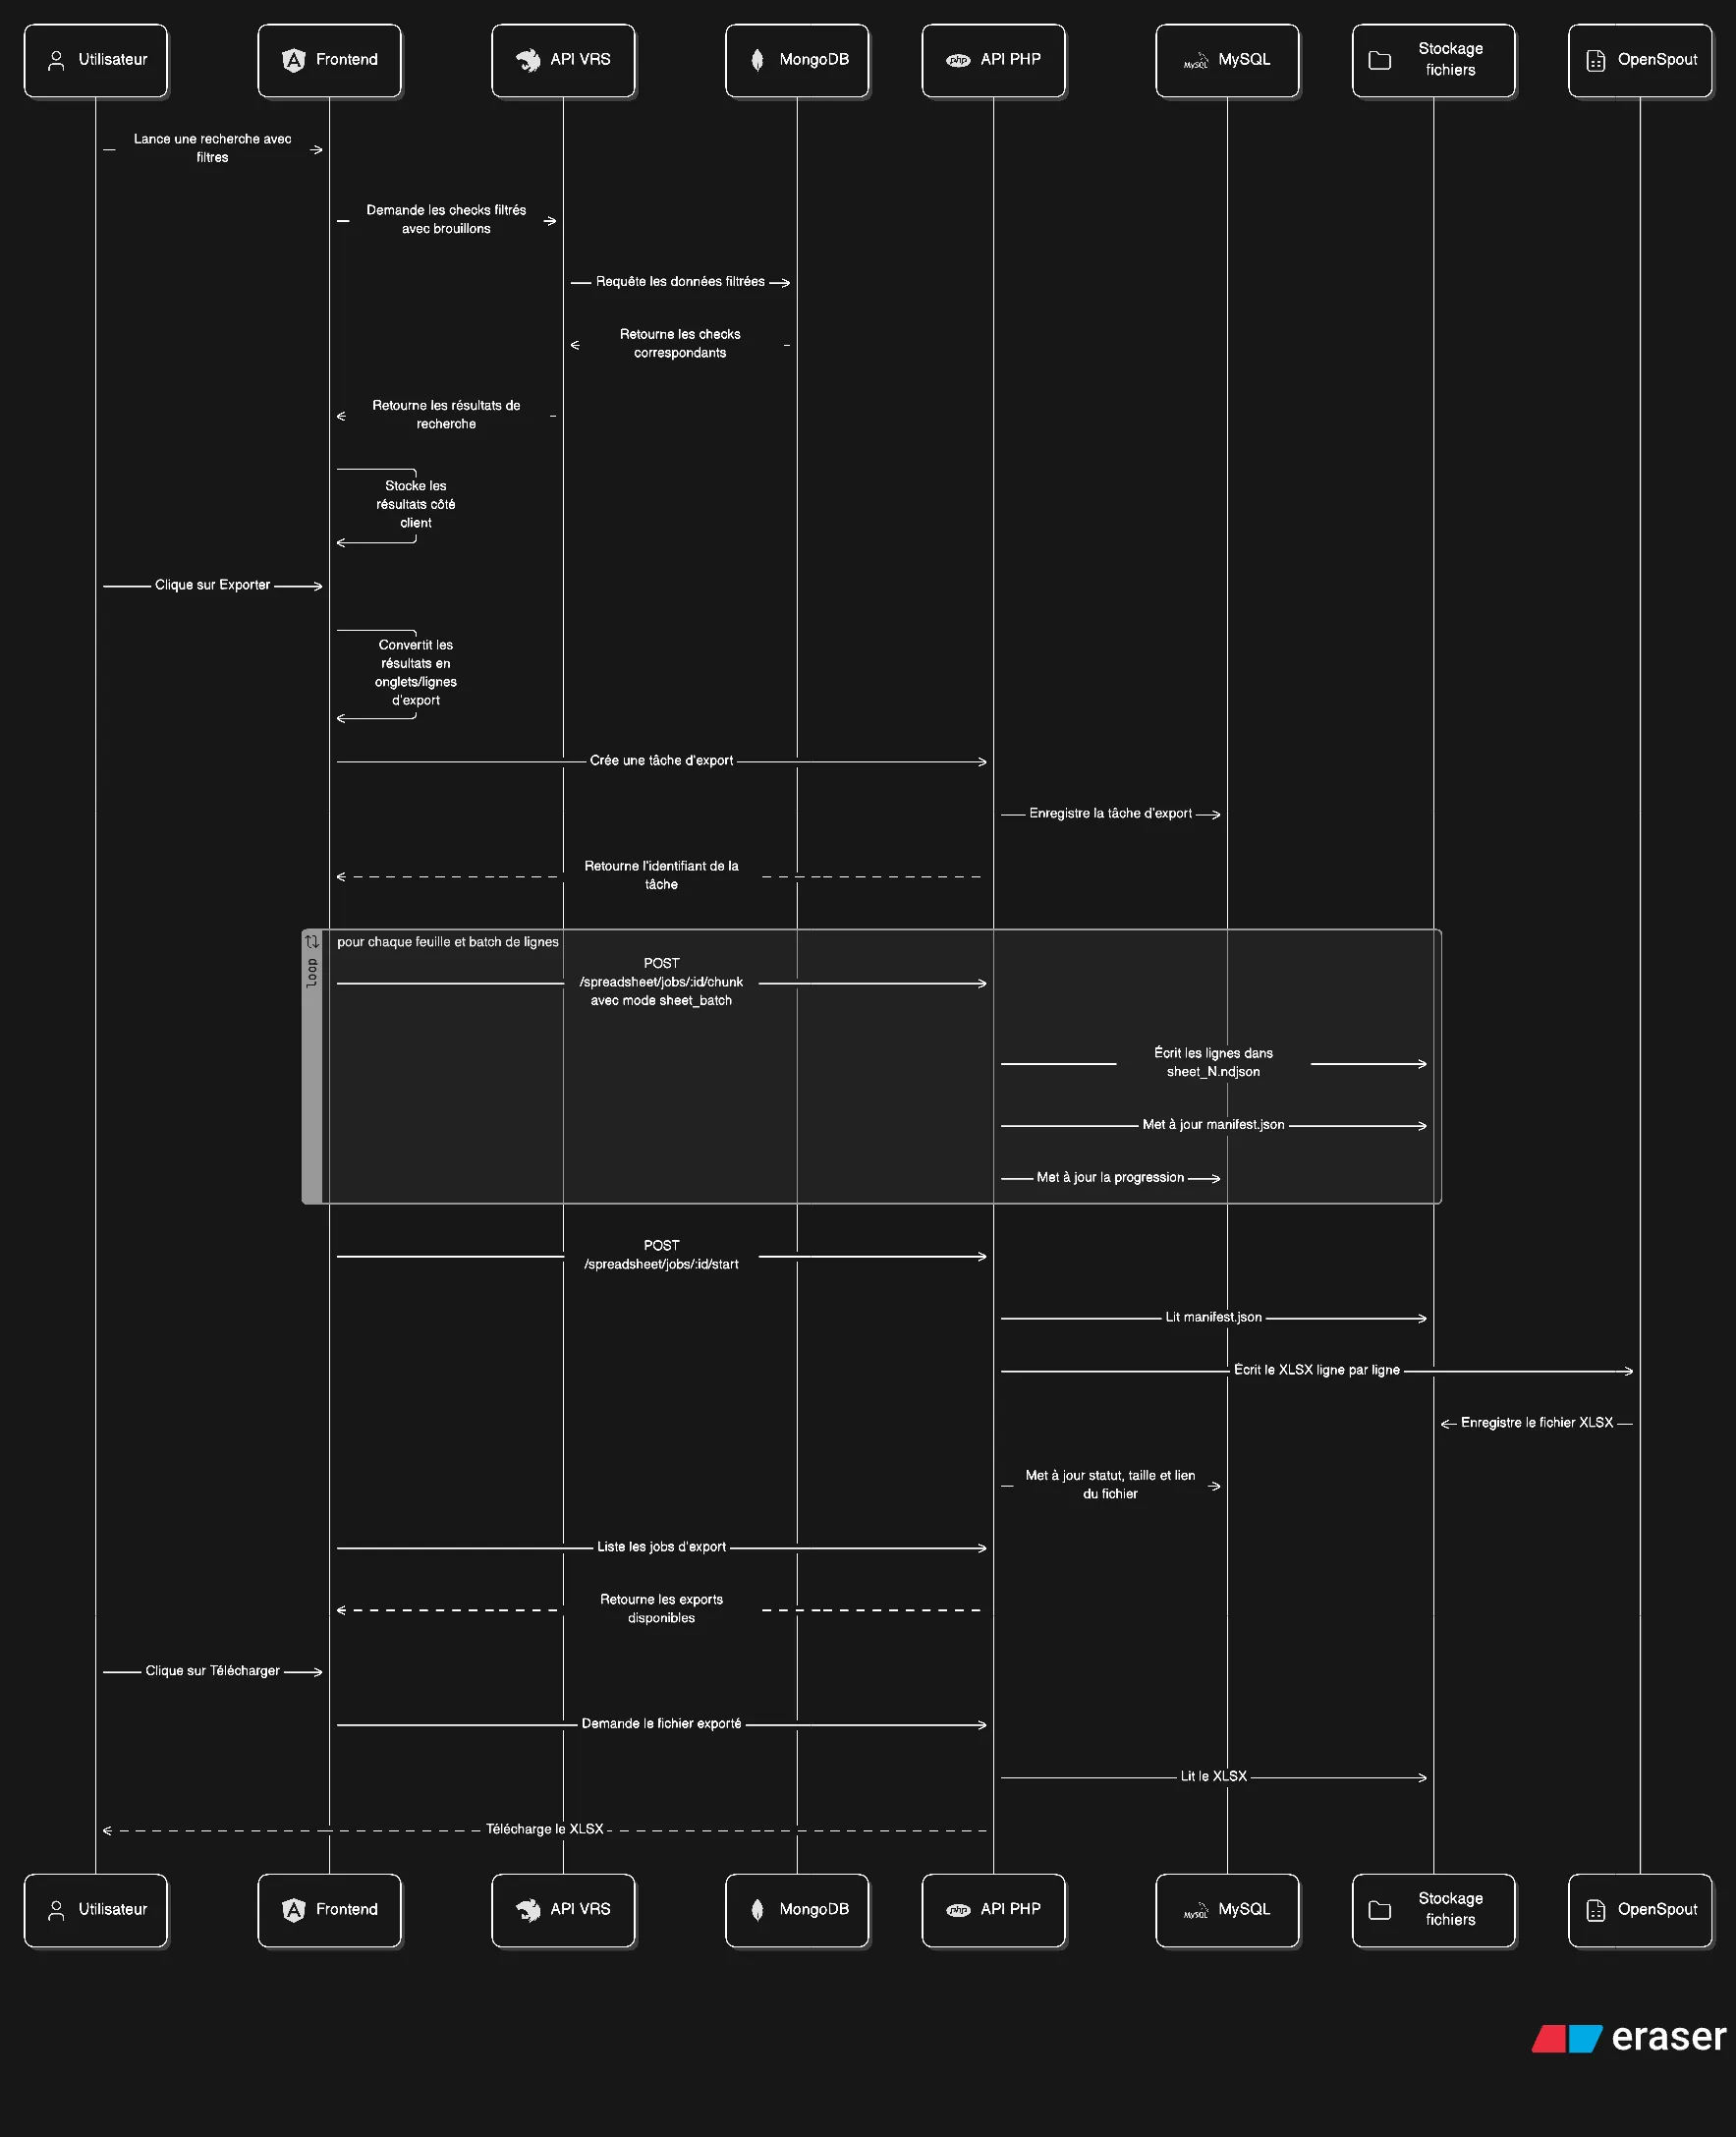
La figure 6 détaille l'envoi des données. Au lieu d'un seul JSON énorme, le frontend envoie les lignes feuille par feuille et lot par lot, au format NDJSON (une ligne JSON par enregistrement). Le serveur les stocke temporairement, puis OpenSpout écrit le fichier Excel ligne par ligne sans jamais tout garder en mémoire. J'ai ainsi transformé un traitement lourd en un protocole simple que l'équipe peut maintenir.
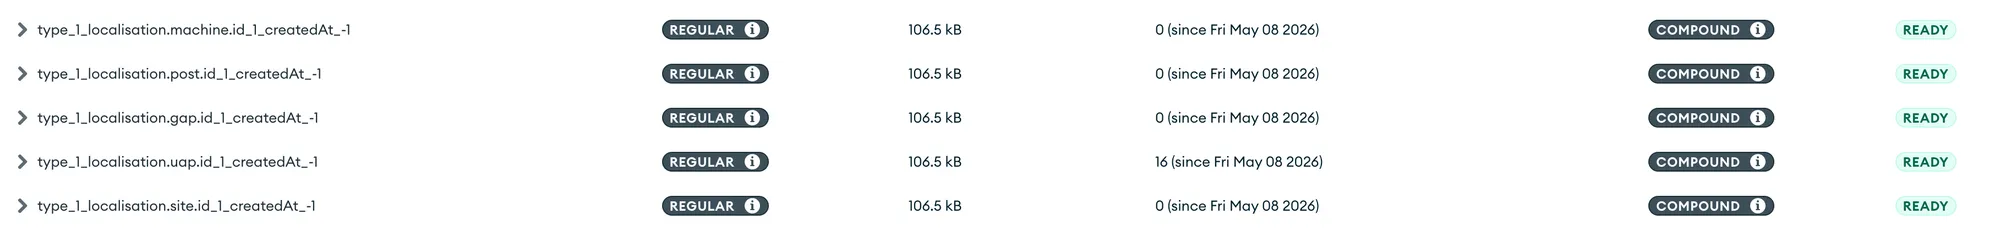
Un export reste lent si la recherche des données l'est. J'ai donc ajouté dans la VRS API (NestJS) un chemin de requête optimisé pour GET /check/list, appuyé sur des index MongoDB (figure 7). Il est activé par défaut, mais l'ancien chemin reste disponible comme solution de repli, ce qui permet de comparer les deux versions sur des données réelles.
Rendre le travail visible pour l'utilisateur
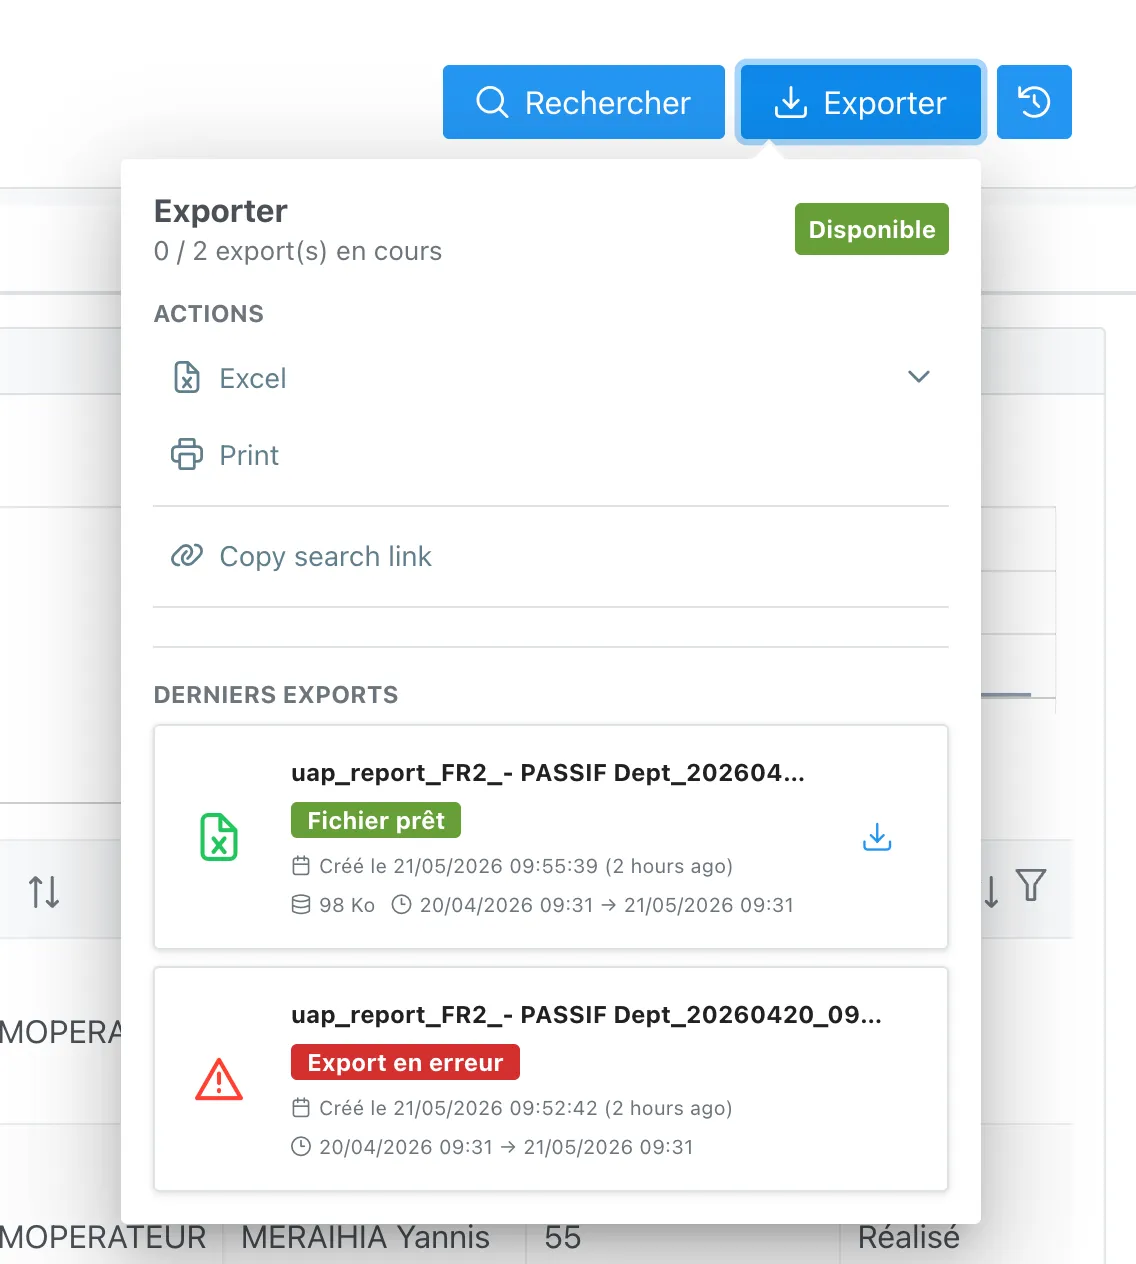
Avant, l'export était une action cachée : on cliquait, on attendait, puis on récupérait ou non un fichier. Le nouveau menu de la figure 8 rend le job visible : historique des derniers exports, statut, progression, téléchargement et suppression. C'est la partie du stage où j'ai le plus travaillé sur l'usage : transformer une contrainte technique en quelque chose de compréhensible.
Travailler dans du code existant
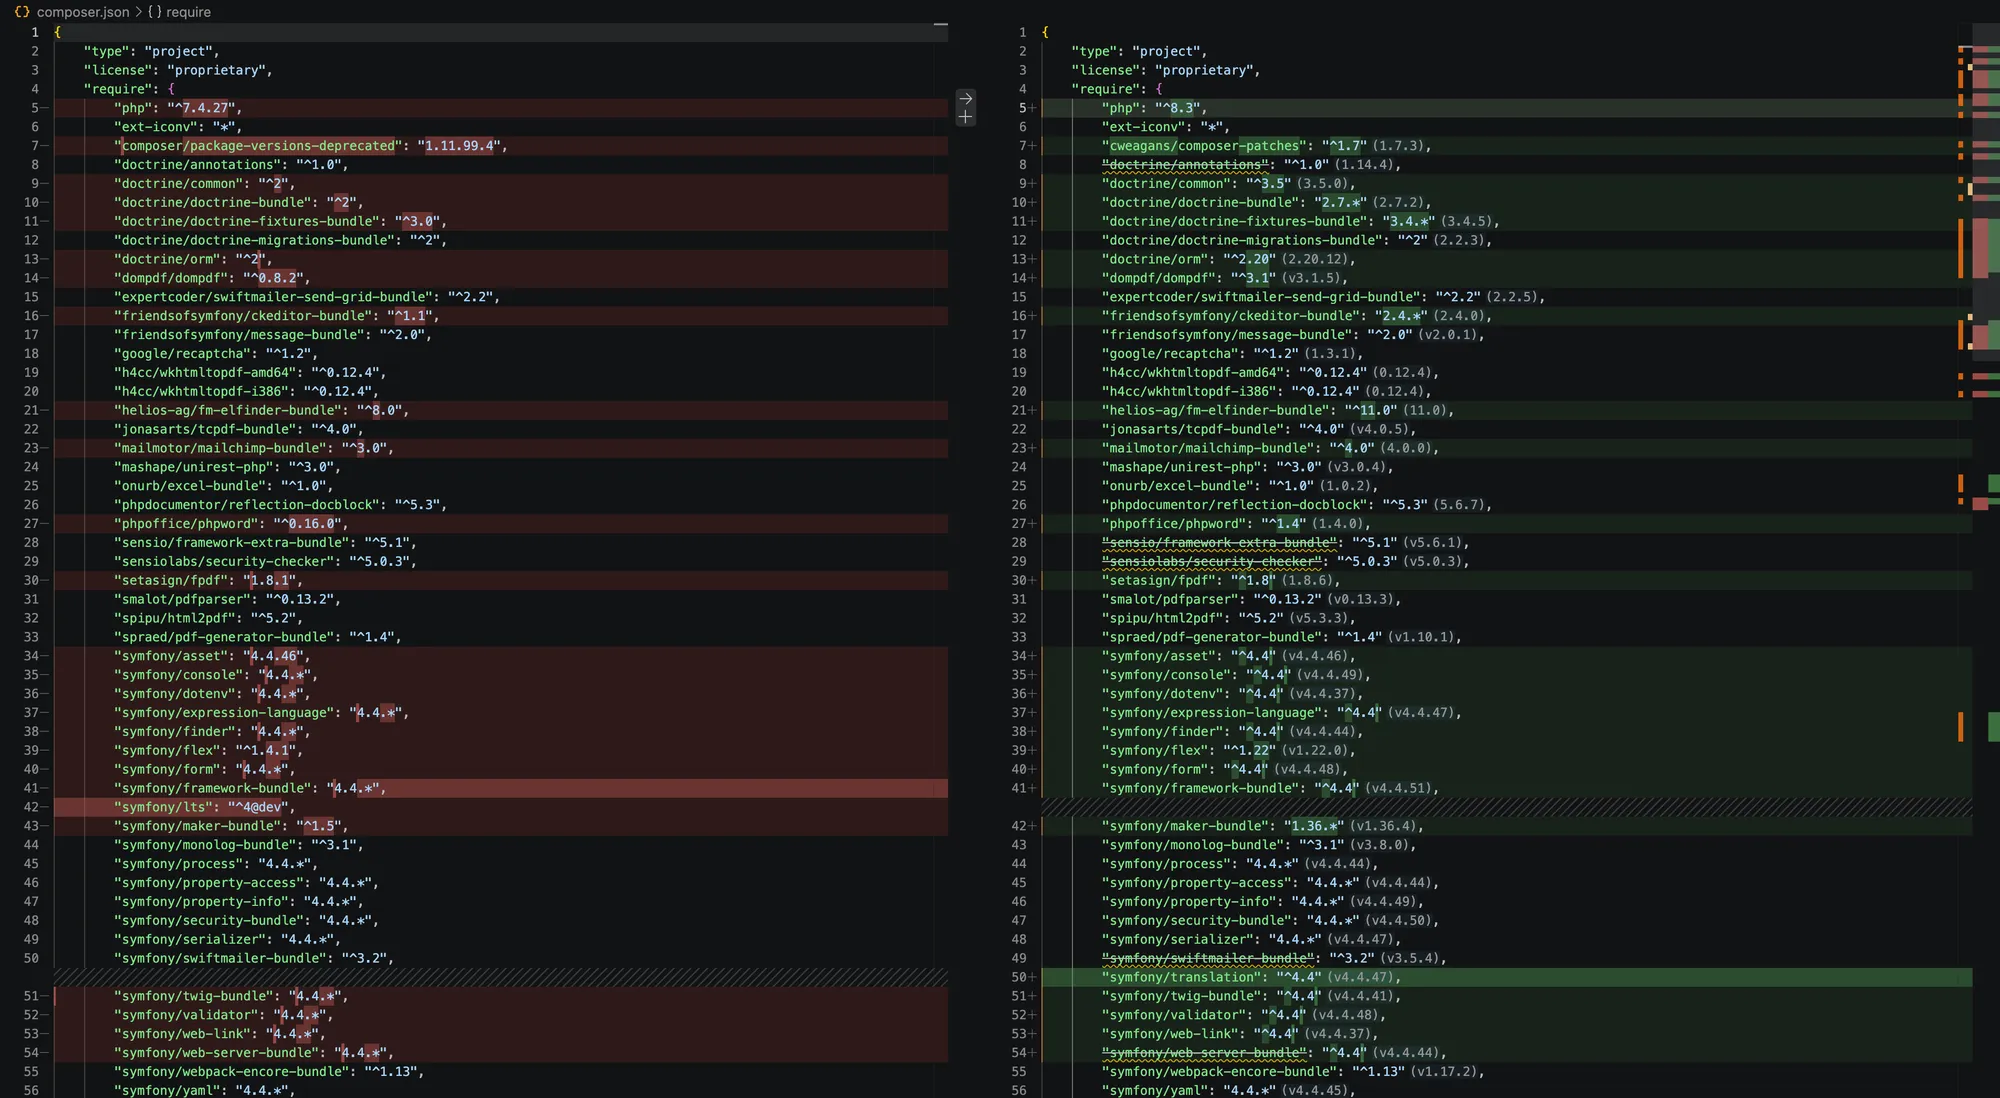
Sur un projet Symfony plus ancien, il fallait d'abord réussir à le faire tourner avant d'ajouter quoi que ce soit (figure 9) : passage à PHP 8.3, mise à jour de Composer et des dépendances, ajout de correctifs. J'ai isolé chaque changement et testé au fur et à mesure pour ne pas casser ce qui fonctionnait déjà.
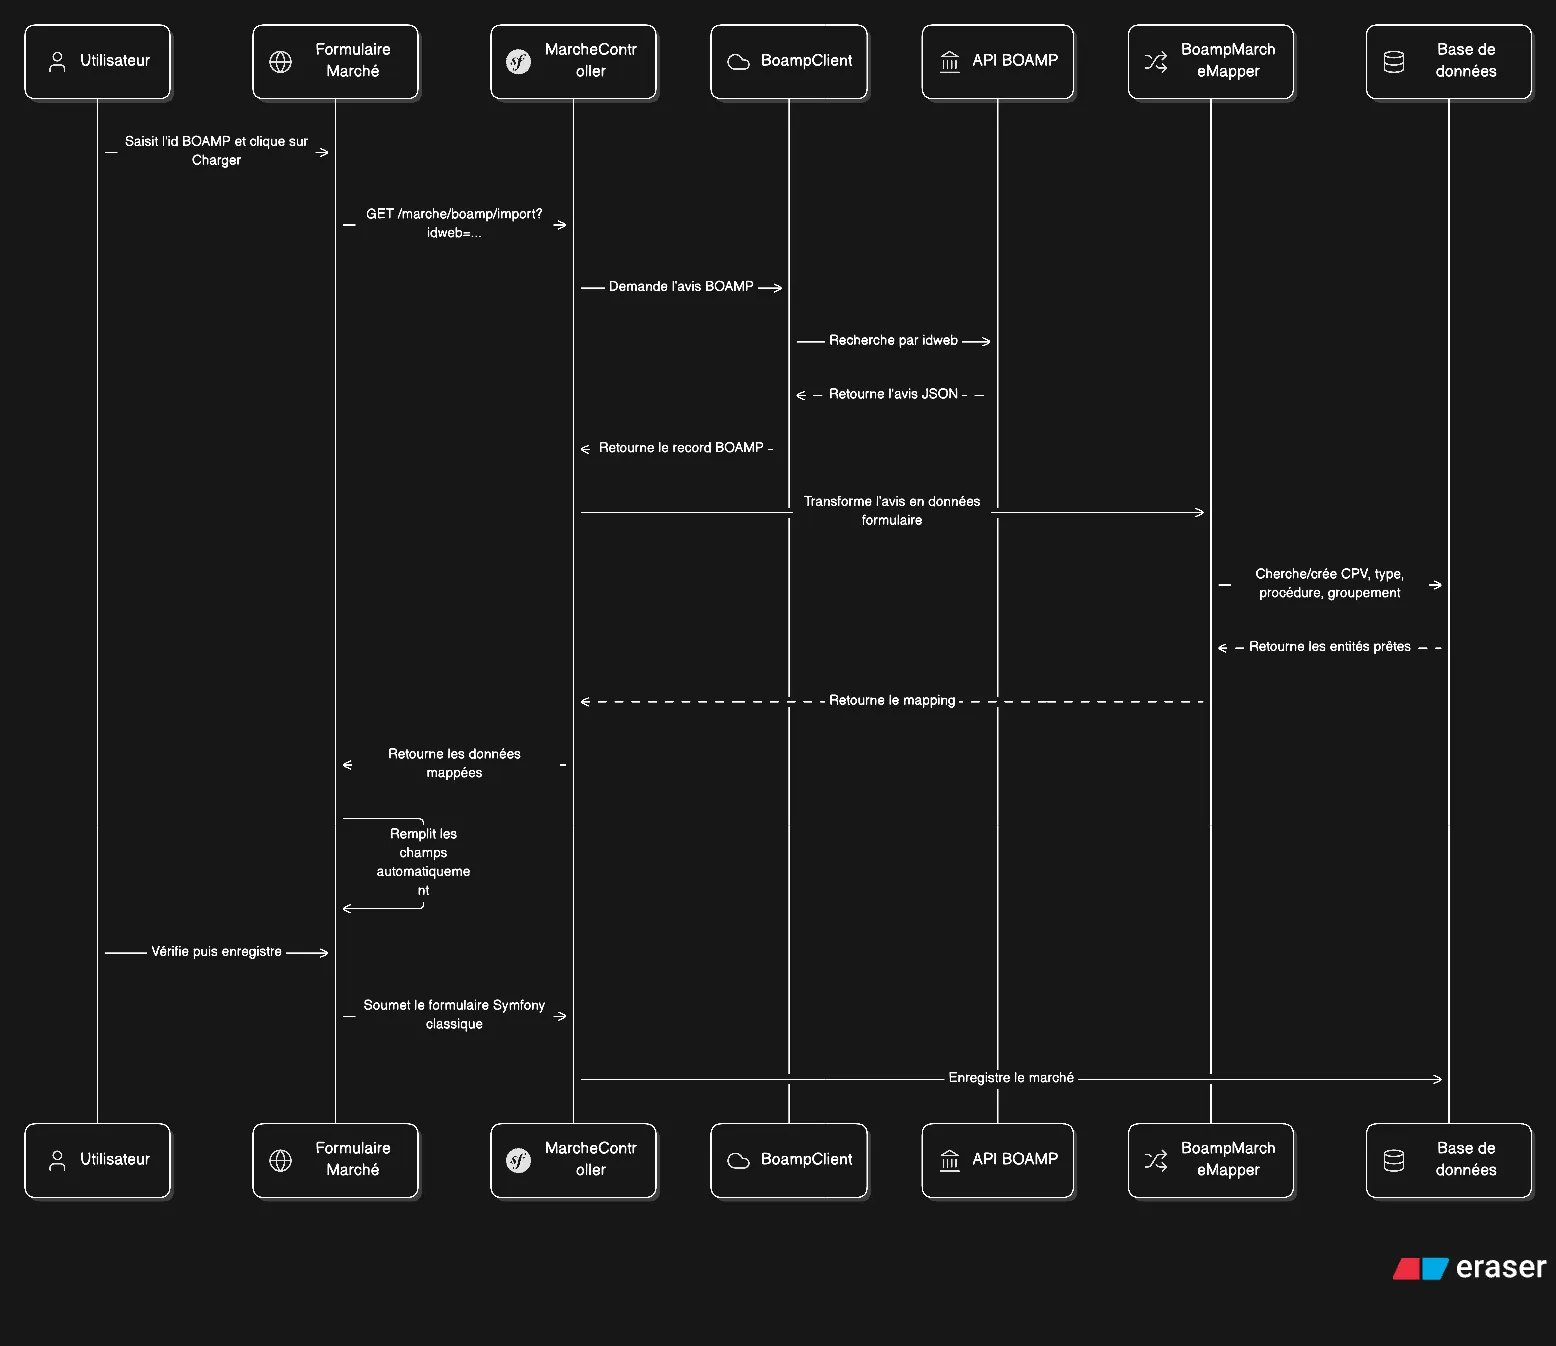
L'import BOAMP (figure 10) aide les écoles à créer des marchés et des fournisseurs en récupérant des informations déjà publiées sur le Bulletin officiel des annonces de marchés publics. Le plus important n'était pas l'appel à l'API, mais de remplir correctement les bons champs et de réutiliser les valeurs déjà présentes dans l'application.
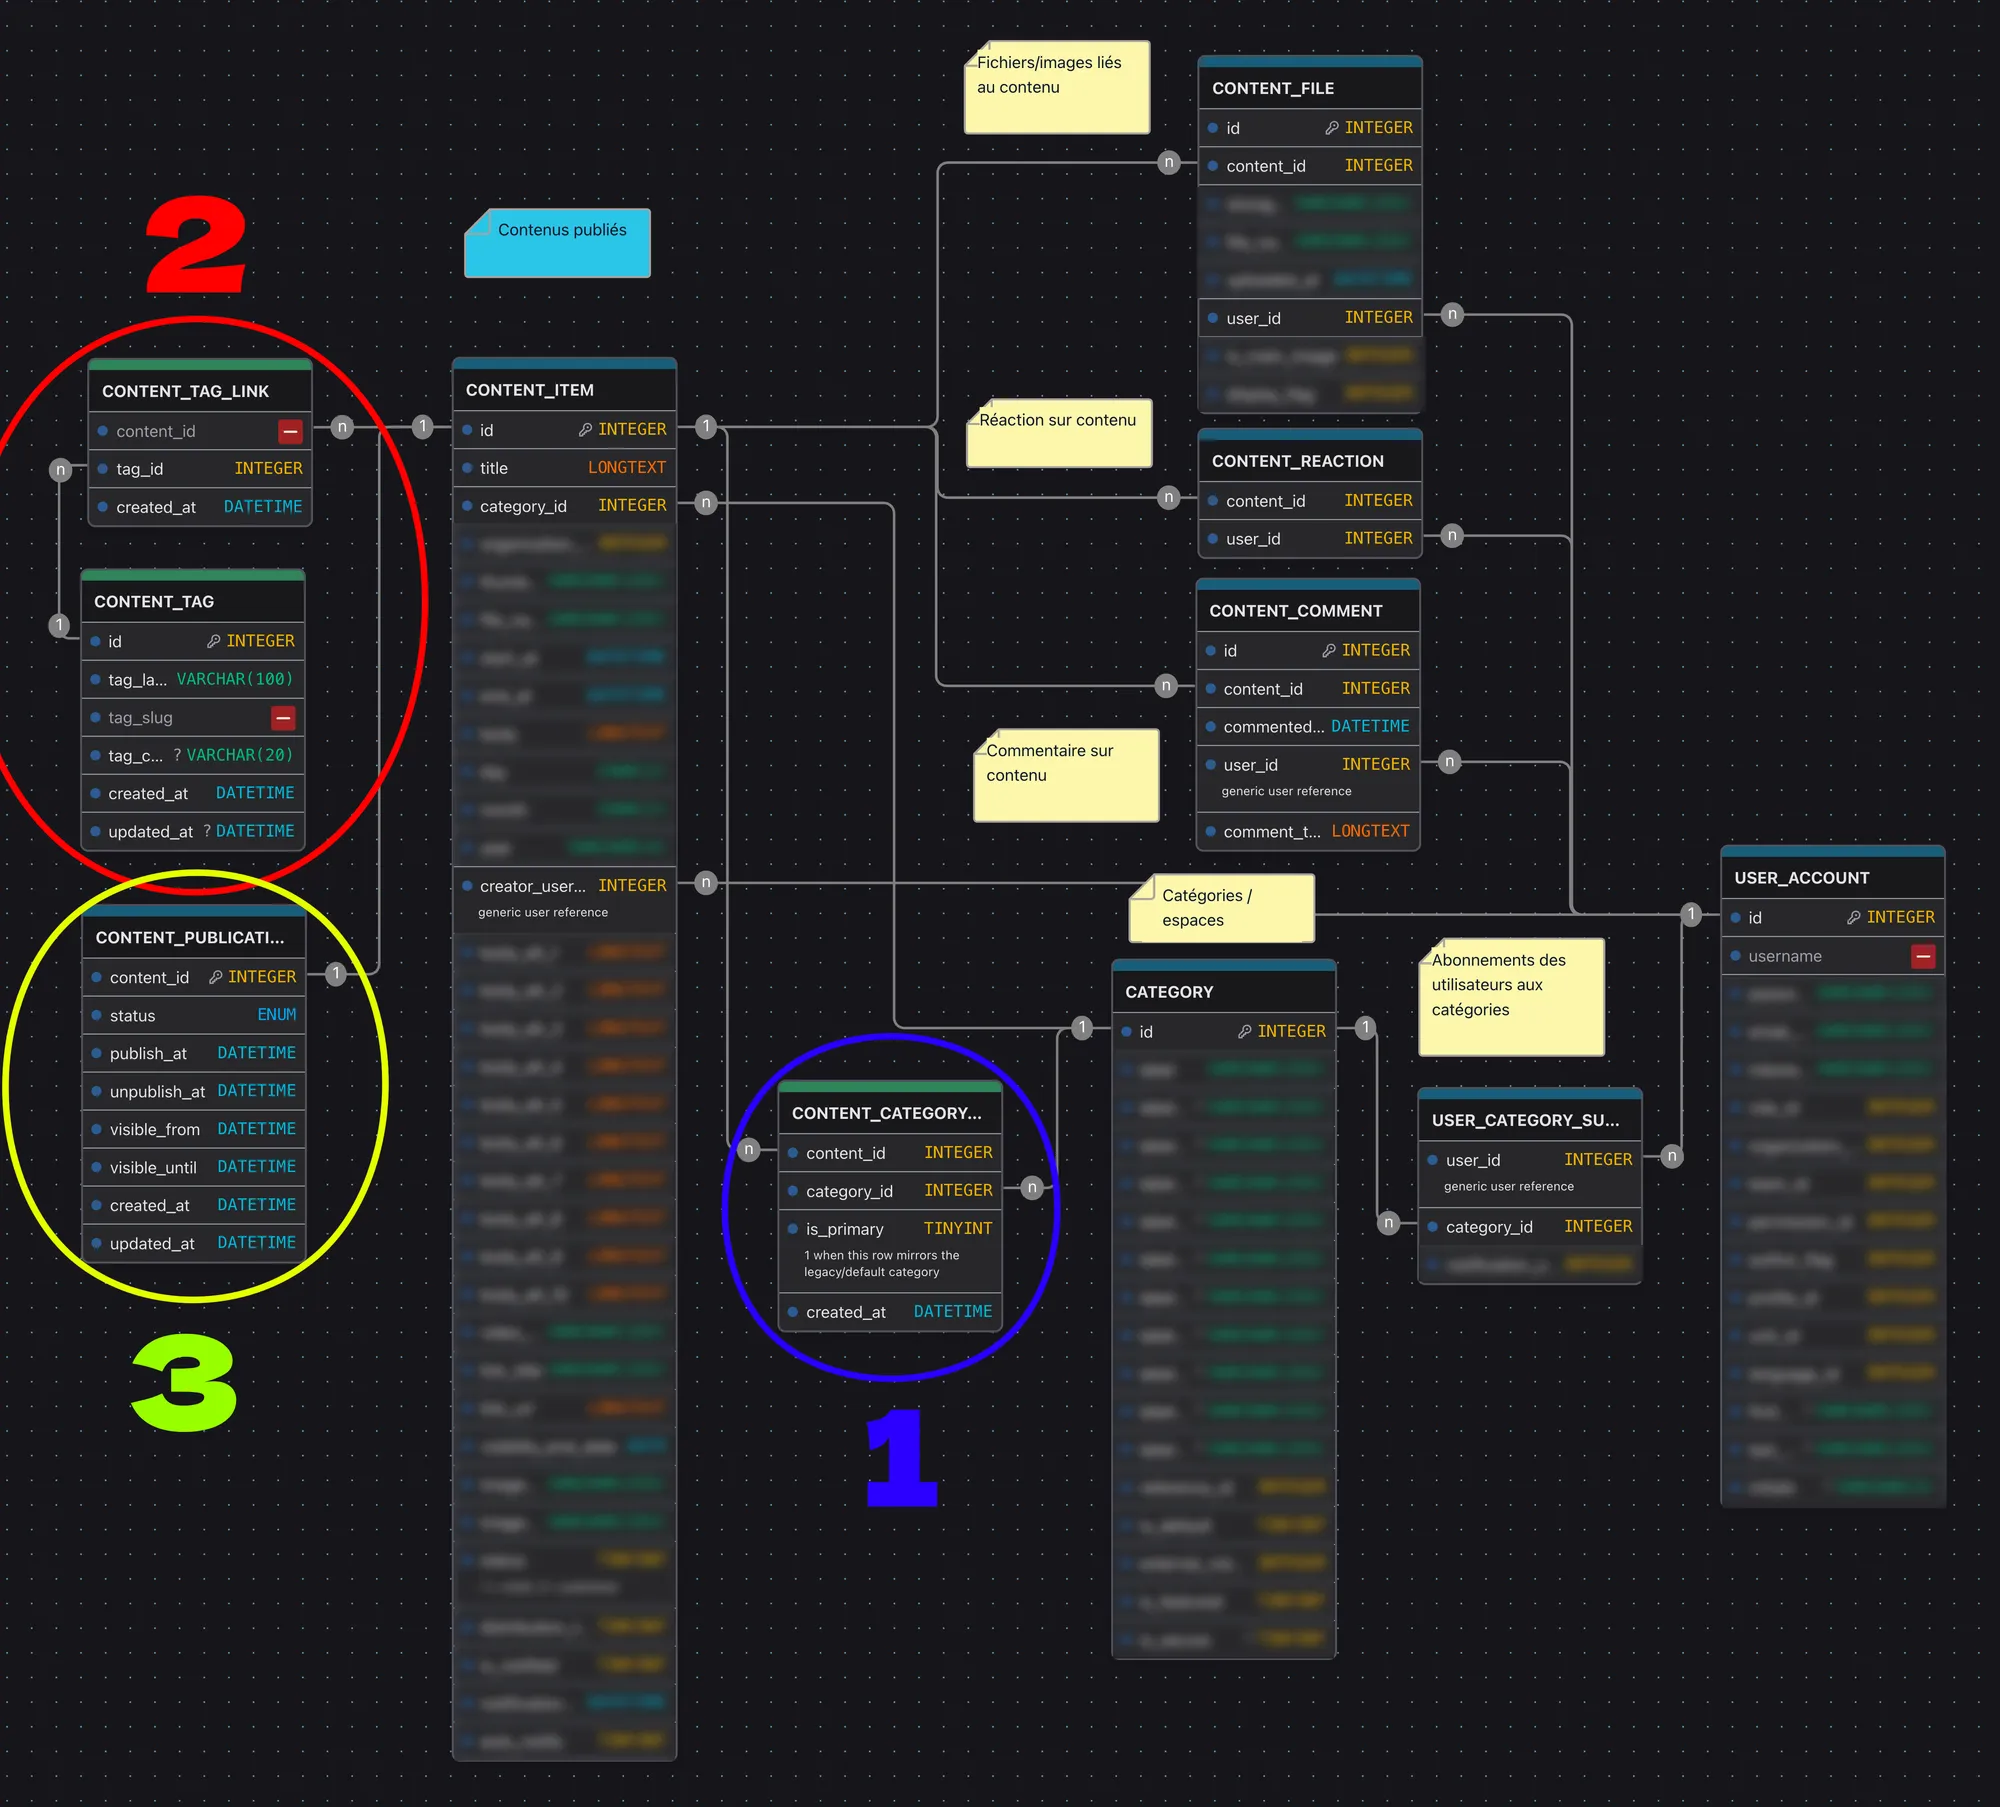
Enfin, la figure 11 montre une phase différente : comprendre un module avant d'en proposer la refonte. J'ai annoté le modèle de données du système de blogs et de forums pour préparer une discussion avec l'équipe (associer un article à plusieurs forums, ajouter des tags…), alors que le cahier des charges n'était pas encore fixé.
Bilan
Ce stage m'a appris à entrer dans une base de code que je n'avais pas écrite, à justifier mes choix par des mesures, à documenter pour l'équipe et à penser à l'utilisateur final, même sur un sujet très technique. Ma documentation complète de stage, avec dix traces détaillées et le bilan de chaque compétence, a été présentée lors de ma soutenance de BUT 2.